同じ画像なのに、AIの合否が変わった
2026年9月29日 · Shitate 画像比較パイロット
「複数の画像モデルから候補を選べば、良い1枚に近づけるか」。それを測る前に、選ぶ側のAIに問題が見つかった。同じ画像に対する必須条件の判定が、23試行中9件で食い違っていた。
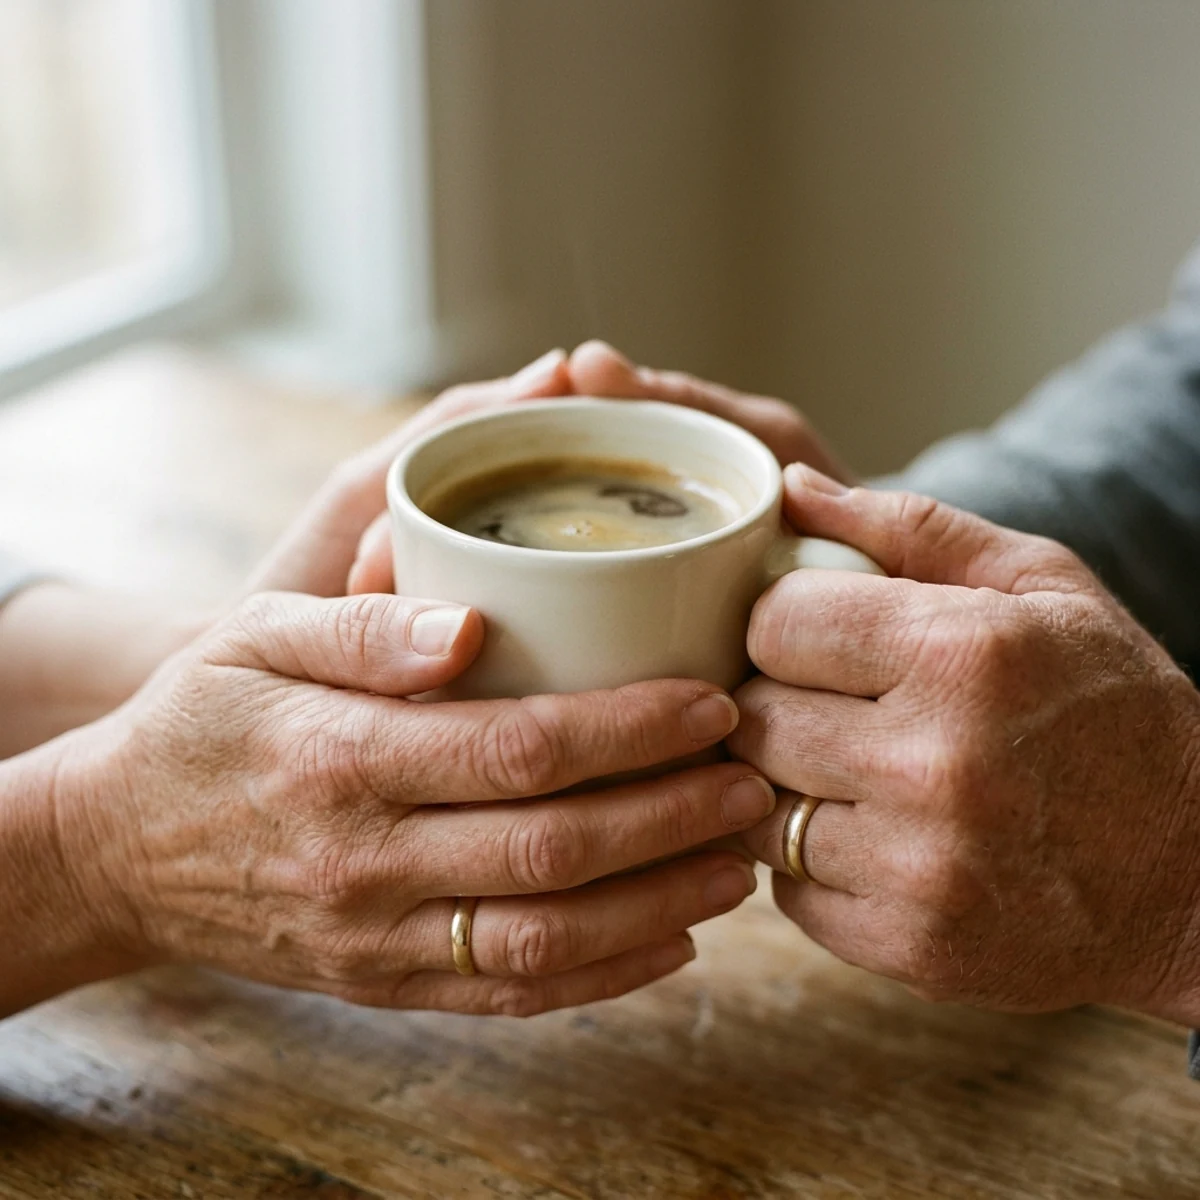
まず実際の画像を見てください。下の1枚はRでは「白いカップ」で合格、Mでは「中に暗い飲み物がある」として不合格。画像自体の正誤を人が確定した「失敗画像」ではなく、AIが不合格とした画像です。
何を測ったか
12課題を各2回実行。1枚だけ作る方式(S)、同じモデルで3枚作って選ぶ方式(R)、異なる3モデルで1枚ずつ作って選ぶ方式(M)を比較した。RとMは1枚の画像を共有し、AIがそれぞれの候補群で別々に採点する。各試行で最大5枚を生成し、保存された実画像は115枚。生成に失敗・中断した5枚は成功扱いにしていない。
ここでの「組み合わせ」は既存モデルを使う選択フローであり、新しいモデルの重みを学習したものではない。主指標は独立した人による匿名のM対R選好だが、人手評価はまだ0件。MがRより良いとは言えない。
元の採点に戻って確かめた
比較可能な23試行中、共有画像の必須条件に不一致があったのは9件、合格/不合格が逆転したのは8件。点数が異なる試行も17件あった。元の46判定について保存済み採点を現行のデコーダーで再計算したところ、合否・点数・選択・理由はすべて再現できた。保存画像のSHA-256も一致した。これは元のAI採点内容の矛盾であり、どちらが正しいかを確定したものではない。
例えば同じカップを、一方は「白いカップ」として合格、もう一方は「中に暗い飲み物がある」として不合格にした。同じランプは「椅子の後ろ」と「横」で判定が割れた。画像を目視して正解を確定したわけではない。不一致9件の画像と日本語の説明へ ↓
原因は一つに断定できない
元の判定AIは出力のランダムさを抑える設定(温度0)だった。画像が候補群で同じ表示位置だった6試行でも2件で必須条件が割れ、異なる位置だった17試行では7件だった。他候補の文脈、位置、呼出ごとの変動は同時に変わるため、位置だけが原因だとは言えない。また元の送信内容全体は保存されておらず、当時のリクエストのバイト列を再検証することはできない。
他候補を固定し、共有画像だけRの採点でMに揃えるとMの選択が3/23件変わり、逆にMの採点でRに揃えるとRの選択は5/23件変わる。これは選択の感度分析であり、品質が上がるという証拠ではない。
次の採点設計
まず不一致9件を人が条件ごとに「合格・不合格・判断保留」で確認する。AIの理由を読んだ後の確認は、匿名ブラインド評価には混ぜない。次の実験案は画像を候補群から独立に一度だけ採点し、同じ採点記録をRとMで共有すること。同じ画像への二重判定は防げるが、誤判定も両群に共有される。実装・未使用課題での評価・費用比較はまだ行っていない。
各画像を個別採点すれば1試行で最大5回の判定AIの呼出となり、従来の群ごと最大2回より呼出数が増えうる。モデル・指示・画像・参照画像・採点基準・重みを含むキーで記録を固定し、過去の結果は差し替えず別の版で比べたい。
費用と検証範囲
元の実験の記録済み費用は$10.3358597、既存の再判定は$0.28167579、合計$10.61753549。費用不明の呼出が5件あり、確定総額ではない。今回の監査は追加API呼出0。12課題の2反復という探索的実験で、24個の独立課題ではない。
画像の正しさは未確認。公開画像は元画像を表示用に縮小・変換したもの。元画像と表示画像それぞれの照合用データ(SHA-256)を根拠データに記載した。日本語の要約は英語の原文に基づく説明であり、採点は修正していない。
不一致9件の画像と判定理由
写真を見ながら、太字の条件とR/Mの合否を比べてください。「不合格」はAIの判定であって、人が画像の失敗を確定した意味ではありません。日本語の説明の下から英語原文を開けます。英語原文・照合用データ(JSON)
画像と根拠を読み込み中…